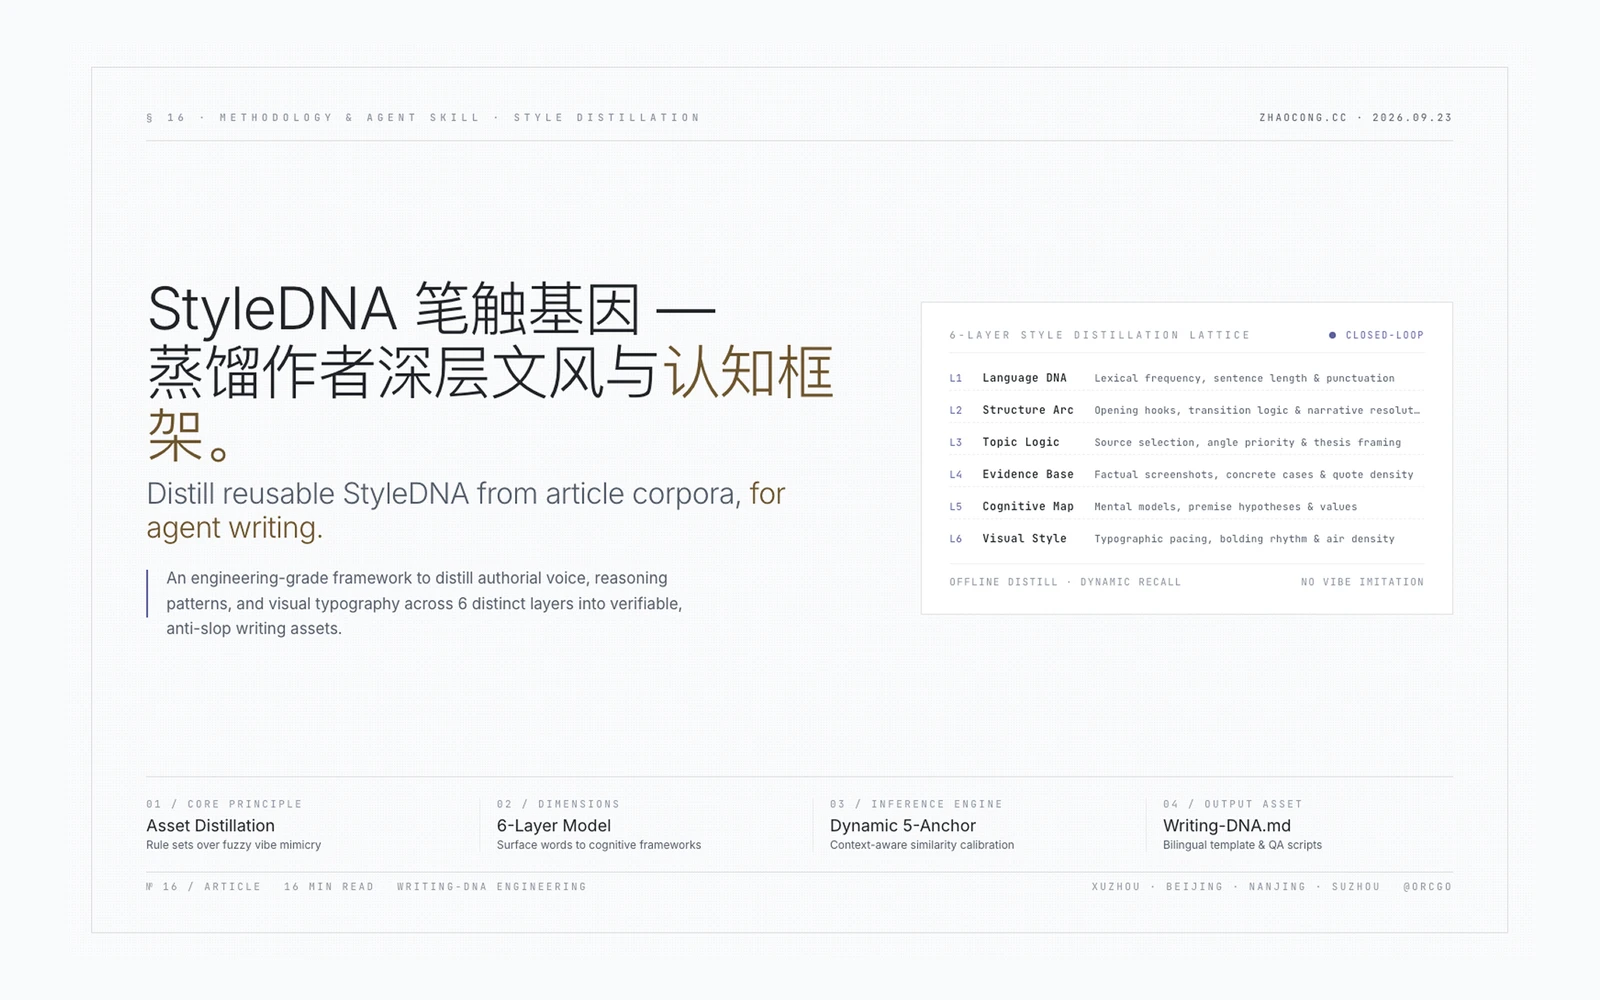
StyleDNA(文风DNA / 笔触基因)是一套用于深度蒸馏作者写作风格、认知框架与视觉排版的 Agent Skill 与工程化工具链。它不是简单的“模仿某某语气”的单次浅层提示词,而是将多篇完整历史文章深度解构为可复用、可量化、可自检的“风格规则资产集”,并通过动态智能召回、分层上下文组装与量化质检机制,实现高保真度、去 AI 腔调的受控文风复刻。
一、核心理念与痛点解决
传统 AI 仿写的典型痛点
- 凭感觉抓表面语气:仅提供 1-2 篇样例让模型“照着写”,模型往往只能捕捉到高频副词或表层口癖,内在论证逻辑与节奏完全失真。
- 上下文过载与注意力衰减:直接将 20 篇长文一股脑塞入 Prompt,导致长上下文注意力遗忘(Lost in the Middle),无法提取深层规律。
- 严重的 AI 八股套路:即使风格大致相似,模型输出仍频繁出现“不仅如此”、“综上所述”、“这不仅仅是一次……更是一场……”等典型机械连接词。
- 忽视视觉排版与证据截图:图文账号的风格很大程度体现在排版密度、加粗节奏以及截图在论证链中的承重功能,传统文字仿写完全丢失了这些维度。
StyleDNA 的解决之道
StyleDNA 采用**“离线资产蒸馏 + 在线分层校准 + 量化质检拦截”**的工程化闭环,将模糊的“写作语感”拆解为 6 个客观维度的规则清单,并提供开箱即用的自动化统计与评估脚本。
二、双轨语言与产物映射规范
将“对话语言”和“产物语言”分开处理:
- 默认对话交互:使用用户的对话语言进行交互,除非用户明确指定其他语言。
- 产物语言优先级:用户明确指定产物语言时以用户选择为准;未指定时,使用原始语料的主要语言;语料混合且无法判断时,使用对话语言。
- 产物模板映射:
- 中文产物使用
templates/author-corpus/zh/,产物命名为中文。 - 英文产物使用
templates/author-corpus/en/,产物命名为英文。
- 中文产物使用
| 分析产物 | 中文文件名 | 英文文件名 | 核心关注点 |
|---|---|---|---|
| L1 语言 DNA | 语言DNA.md |
language-dna.md |
词频、句长、标点习惯、中英文混用方式 |
| L2 文章结构 | 文章结构模板.md |
structure-patterns.md |
开头 Hook、正文架构、转折与结尾 |
| L3-L5 认知框架 | 写作视角与认知框架.md |
cognitive-framework.md |
切入角度、素材偏好、核心命题与底层假设 |
| L6 视觉风格 | 视觉风格指南.md |
visual-style-guide.md |
配图位置与类型、加粗密度、段落节奏、排版层级 |
| 最终整合文档 | Writing-DNA.md |
Writing-DNA.md |
总体约束、执行优先级与核心规则索引 |
三、蒸馏的六个层次与跨层原则
| 层次 | 分析对象 | 提取方法 | 输出产物 |
|---|---|---|---|
| L1 表层语言 | 词频、句长、标点习惯、修辞特色 | 脚本统计分析 | 语言DNA.md |
| L2 文章结构 | 开头 Hook、正文架构、转折方式、收束逻辑 | 结构骨架标注与分类归纳 | 文章结构模板.md |
| L3 选题逻辑 | 发布时机、切入视角、话题优先级与禁忌 | 归纳分类与选题决策树 | 写作视角与认知框架.md |
| L4 素材策略 | 引用来源、权威对象、数据与截图角色 | 深度阅读归纳 | 写作视角与认知框架.md |
| L5 认知框架 | 世界观、价值判断、底层假设、核心命题 | 深度阅读提炼 | 写作视角与认知框架.md |
| L6 视觉风格 | 配图策略、图文间隔、排版层级、加粗密度 | 图文统计与排版分析 | 视觉风格指南.md |
核心原则:L1-L2 是“怎么写”,L3-L5 是“怎么想”,L6 是“怎么呈现”。完整的风格复刻需要三者结合。
跨层原则:图片内容必须纳入分析
许多文章的图片不是装饰——截图、对话记录、数据表格、用户评论中的文字是论证链的一部分。分析时必须打开图片查看内容:
- L2 文章结构:截图在叙事中的承重角色(转折点在截图里、证据链由截图构成)。
- L4 素材策略:截图是核心素材形式,精确数据往往只存在于图片中。
- L6 视觉风格:图片的功能分类(证据型/演示型/数据型/叙事推进型/情绪型/权威型)和图文协作模式。
- 执行要求:在分析中,至少抽样 5-10 篇文章逐张查看图片内容,评估图片携带的实质性信息比例。
四、内置自动化脚本工具链
在 scripts/ 目录下提供了完整的 Python 脚本工具,支持标准库回退运行(无需复杂环境配置):
1. 语料特征统计分析
自动解析指定语料目录中的 .md 或 .txt 文章,提取统计学层面的语言特征:
- 自动计算平均句长、短句(≤15字)占比、长句(≥50字)占比。
- 统计高频核心名词、动词、修饰词及常用副词。
- 统计核心标点符号分布(破折号、括号、冒号、省略号、问号、感叹号、双引号)。
- 统计每千字加粗密度及小标题平均字数。
# 运行分析并将 Markdown 报告保存至目标文件
python3 scripts/analyze_corpus.py raw/ -o 语言DNA.md

# 或以 JSON 格式导出统计数据
python3 scripts/analyze_corpus.py raw/ --json > stats.json
2. 视觉排版与图文特征提取
解析文章中的 Markdown / HTML 排版与多模态配图标记:
- 统计篇均配图数量、每千字图片密度与图文间隔段落数。
- 分析首图/封面图存在率与配图功能说明(Alt Text 采样)。
- 统计 H1-H4 各级标题分布、引用块、代码块、分割线与列表项密度。
# 自动生成视觉风格指南初稿
python3 scripts/analyze_visual.py raw/ -o 视觉风格指南.md
3. 相似语料智能召回器
在写作前,根据用户当前输入的写作主题、关键词或体裁,利用 BM25 算法与 _meta 元数据标签,自动从 raw/ 语料库中检索出最贴近的 5 篇参考原文:
- 综合匹配文章标题、主题标签、体裁及正文语义。
- 支持按时间衰减加权(优先匹配近期风格)。
- 支持一键导出合并后的 Prompt 上下文。
# 检索 Top-5 匹配文章并在终端展示得分榜
python3 scripts/retrieve_context.py . -q "AI智能体协同工作与软件工程" -t "深度分析"

# 检索并将 5 篇参考原文合并导出为 prompt_context.md
python3 scripts/retrieve_context.py . -q "AI智能体协同" --export-context prompt_context.md
4. 风格吻合度量化评估器
写作完成后对成稿进行量化质检(百分制):
- 指标对比:检验成稿的句长均值、长短句比例、加粗密度是否落在目标作者的基准区间内。
- AI 味精准扫描:内置 6 大类常见 AI 套话检测正则(空洞过渡词、夸大象征修辞、冗余填料词、机械三段论连接、过度否定排比、老套升华结尾等)。
- 扣分与改进建议:输出诊断分析与定向修改意见。
# 评估生成文章与 语言DNA.md 的吻合度
python3 scripts/eval_style.py output_article.md -d 语言DNA.md
五、端到端标准蒸馏流程 (Step 1 - Step 7)
Step 1:原始素材收集
目标:建立该账号/作者的文章语料库。
- 收集渠道:公众号、博客、Newsletter、官网、社交平台等历史文章。
- 数量建议:至少 20 篇完整文章(覆盖不同时期与类型)。
- 文件格式:
.md或.txt,存入raw/文件夹。 - 命名规范:
YYYY-MM-DD 内容类型 文章标题-来源.md
Step 2:元数据标注 (_meta/ 目录)
为每篇文章创建元数据记录,保存为 _meta/{文件名}.json:
{
  "title": "文章标题",
  "date": "YYYY-MM-DD",
  "author": "作者姓名",
  "column": "内容系列名称",
  "article_type": "访谈 | 深度分析 | 短评 | 观察 | 综述",
  "topic_tags": ["AI", "创业", "商业模式"],
  "hook_type": "问题式 | 场景式 | 数据式 | 观点式 | 悬念式",
  "structure_pattern": "总-分-总 | 时间线 | 对比式 | Q&A",
  "source_types": ["一手素材", "公开资料", "案例对比"],
  "word_count": 3200,
  "notable": "值得标注的特殊之处(可留空)"
}
Step 3:脚本统计分析 (L1 表层语言)
运行自带的分析脚本,自动提取表层语言统计特征并输出至 语言DNA.md:
python3 scripts/analyze_corpus.py raw/ -o 语言DNA.md
Step 4:结构骨架标注 (L2 文章结构)
对每篇文章标注结构骨架:
[开头 hook 类型] + [字数]
→ [第一转折点/核心问题引入]
→ [正文结构:总-分 / 对比 / 时间线 / Q&A]
→ [结尾处理方式:收束 / 悬念 / 呼吁 / 自然结束]
归纳后按内容类型整理为可复用的结构模板(如访谈类模板、深度剖析模板等),存入 文章结构模板.md。
Step 5:选题与认知框架提炼 (L3-L5)
通过深度阅读归纳提炼,输出至 写作视角与认知框架.md:
- L3 选题逻辑:切入时机(早期预判/事后复盘)、视角取向、不写的话题清单。
- L4 素材策略:一手/二手引用偏好、权威对象选取、截图在论证中的承重角色。
- L5 认知框架:对主题的核心假设、价值判断标准、反复出现的 3-5 条深层核心命题。
Step 6:视觉风格与排版分析 (L6)
运行分析脚本辅助提取排版数据,并结合人工抽样查看图片内容,输出至 视觉风格指南.md:
python3 scripts/analyze_visual.py raw/ -o 视觉风格指南.md
涵盖:配图策略(图文比、图文间距)、首图风格、图片功能分类、标题层级与加粗强调密度。
Step 7:蒸馏产物总览整合 (Writing-DNA.md)
将 L1-L6 的分析结论整合成一份总控文档 Writing-DNA.md(控制在 4000 字以内):
Writing-DNA.md
├── 语言特征(来自 L1)
├── 结构模板(来自 L2,按类型分类)
├── 选题判断标准(来自 L3)
├── 素材使用规范(来自 L4)
├── 核心认知框架(来自 L5)
└── 视觉风格指南(来自 L6:配图策略 + 排版 + 色彩)
六、高级工作流与机制
海量语料分批蒸馏 (Map-Reduce)
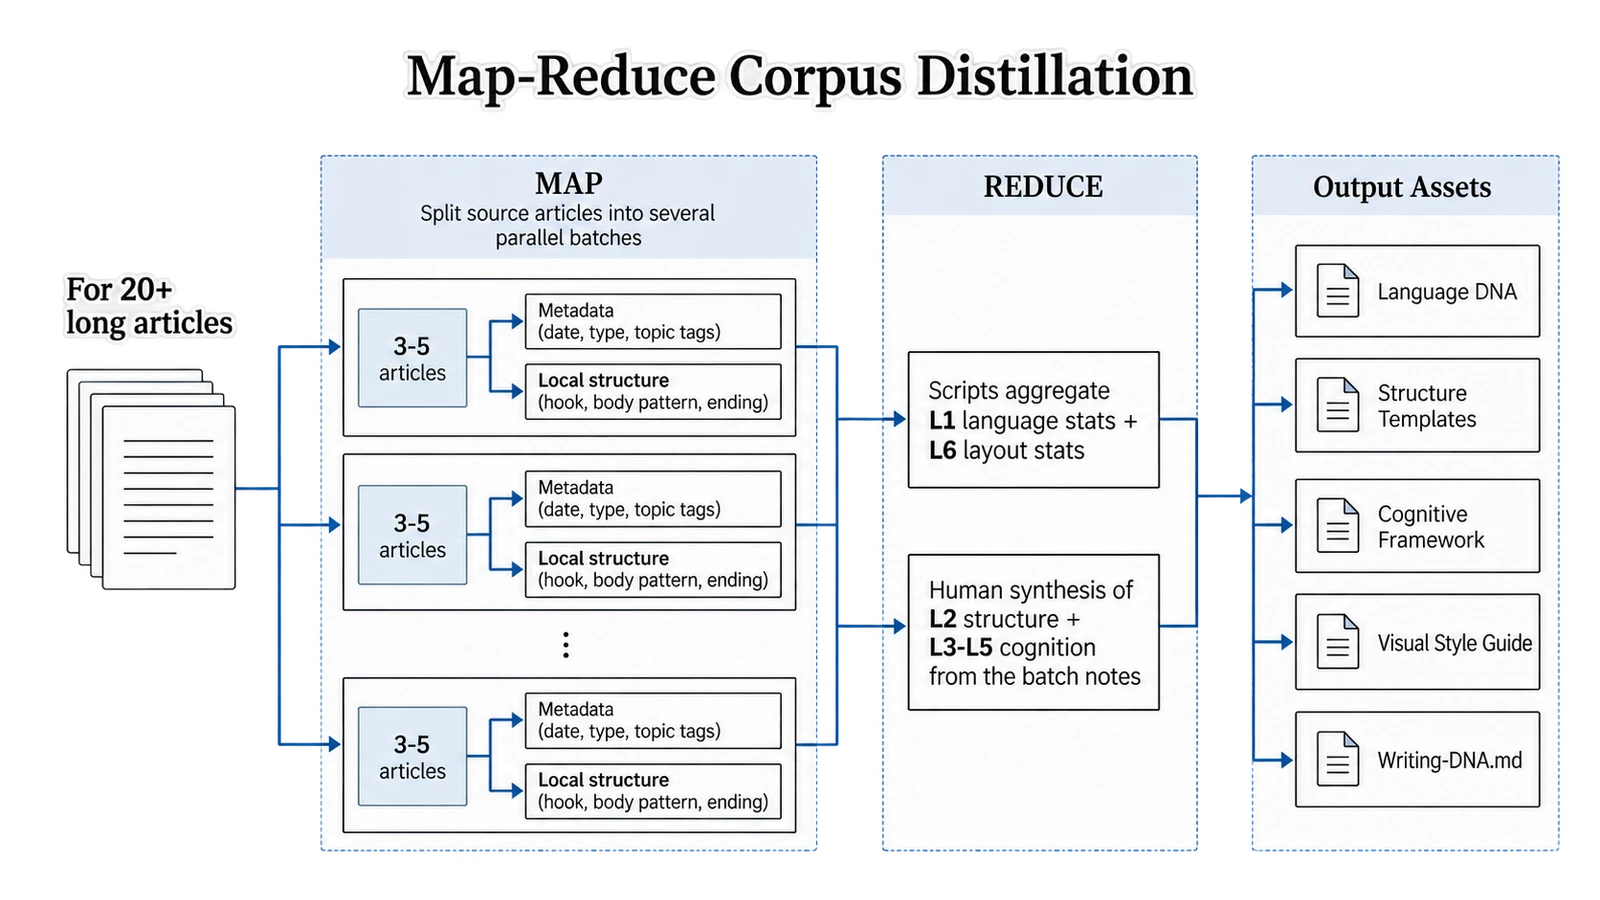
当语料库超过 20 篇且长文居多时,单次喂给模型容易造成上下文溢出。建议采用分批工作流(详见 references/batch_distillation.md):
- Map 阶段:按 3-5 篇一组分批输入模型,仅提取单篇元数据与局部结构片段存入
_meta/。 - Reduce 阶段:运行自动化分析脚本全量汇总 L1/L6 数据,并将全量
_meta/注入模型归纳 L2-L5 全局规律。
增量更新机制 (Incremental Update)
当目标作者发布了新的 3-5 篇文章时:
- 直接存入
raw/并在_meta/中补充记录。 - 重新运行
analyze_corpus.py刷新 L1 统计基准数值。 - 对比新文章是否出现新结构或新观点,增量补充至
文章结构模板.md与写作视角与认知框架.md。
写作前动态 Prompt 组装规范
在调用大模型写作时,建议参考 references/prompt_assembly.md 采用结构化拼装:
[系统角色与任务说明]
   ↓
[本次写作硬性指令:主题、字数、体裁] (最高优先级)
   ↓
[目标作者 DNA 规则约束:L1 语言 + L2 结构 + L3-L5 认知 + L6 排版]
   ↓
[智能召回的 Top-5 相似原文参考片段] (语感校准层)
   ↓
[执行要求:禁止照搬具体事实 + 白名单去 AI 味质检]
规则冲突与优先级仲裁法则
在生成与后处理过程中,若遇到规则冲突,严格按以下顺序仲裁:
- 用户明确指令(本次指定的题材、字数、平台、语言要求)拥有最高优先级。
- L2 结构模板中匹配当前体裁的具体方案。
- L1 语言特征与 L6 视觉排版规范。
- L3-L5 认知框架(指导观点立场与素材选择,不决定句式结构)。
- 蒸馏产物与通用去 AI 味规则冲突时,以目标作者的蒸馏产物为准(保留作者特有的真实语言习惯与标点偏好)。
七、基于蒸馏产物的写作与质检流程
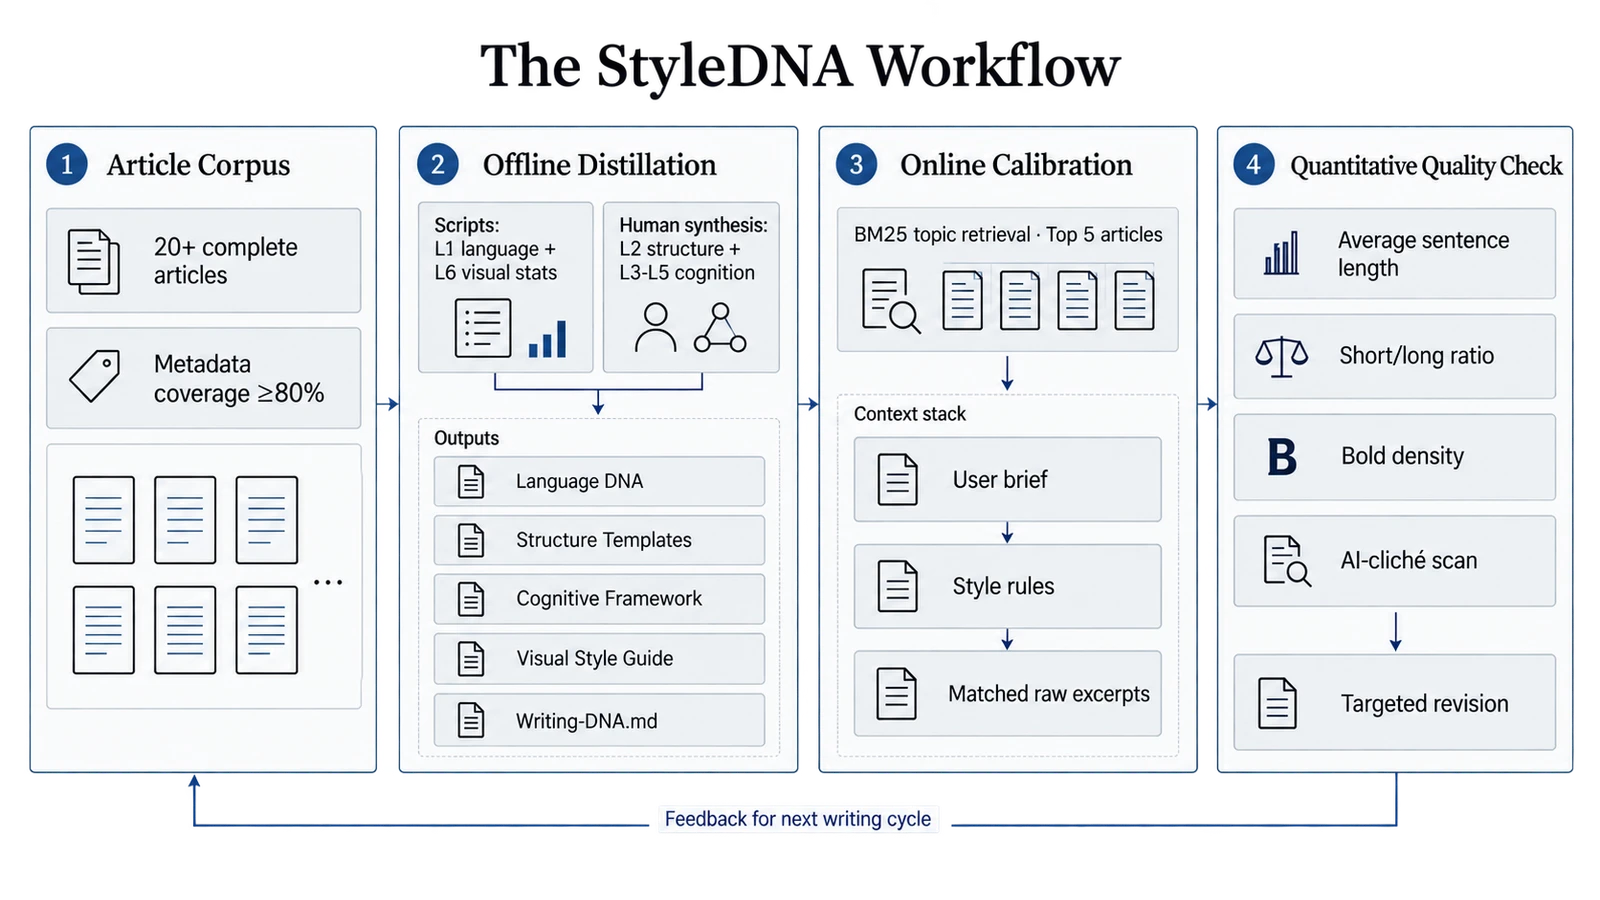 蒸馏完成后,每次按该 DNA 写作前,必须先完成下面的读取步骤。不允许只凭
Writing-DNA.md 或上一轮对话记忆下笔。
7.1 每次写作前必读:四份产物 + 5 篇 raw 原文校准
第一步:读完全部蒸馏产物(四份分层产物 + 整合文档,一份都不能跳过)
| 读什么 | 中文文件名 | 英文文件名 | 提取什么 |
|---|---|---|---|
| L1 语言 | 语言DNA.md |
language-dna.md |
高频词、句长分布、标点习惯、中英混用方式 |
| L2 结构 | 文章结构模板.md |
structure-patterns.md |
匹配本次体裁的结构模板 |
| L3-L5 认知 | 写作视角与认知框架.md |
cognitive-framework.md |
切入角度、素材偏好、核心命题 |
| L6 视觉 | 视觉风格指南.md |
visual-style-guide.md |
配图位置与类型、加粗密度、段落节奏、分隔方式 |
| 整合 | Writing-DNA.md |
Writing-DNA.md |
总体约束与优先级 |
第二步:智能召回并通读 5 篇相关的 raw 原文
使用内置召回脚本,自动检索 5 篇与本次题材与体裁最贴近的参考文章:
python3 scripts/retrieve_context.py <作者目录> -q "本次写作主题与关键词" -t "体裁(可选)"
- 读 raw 的目的:校准分层产物无法完全量化的“句子的实际呼吸感”、段落接合方式、突发短句的使用时机以及口语/书面语交融方式。读完要能说出这 5 篇的共同语感,再开始起草。
- 红线约束:原文里的具体观点和事实不能直接搬进新文章——复刻的是写法,不是内容。
7.2 后处理:白名单去 AI 痕迹与量化评估
- 白名单式清理 AI 味:写作完成后,使用
skills/lieflat-less-ai-tone/规则集清理 AI 痕迹。它只处理清单内的问题,没命中的句子逐字保留,不改文章框架。 - 量化验收:运行
scripts/eval_style.py检验吻合度并筛查 AI 套话:python3 scripts/eval_style.py <生成文章路径> -d <语言DNA.md路径>
八、质量验收标准 Checklist
- 语料库包含至少 20 篇完整文章,
_meta/元数据覆盖率 ≥ 80%。 - 运行
analyze_corpus.py提取了客观严谨的语言统计基准。 -
文章结构模板.md覆盖了至少 3 种常见内容体裁。 -
写作视角与认知框架.md提炼出至少 3 条非显而易见的深层核心命题。 -
视觉风格指南.md明确了配图功能角色、图文间距与排版层级。 -
Writing-DNA.md精炼在 4000 字以内,无冗余空话。 - 写作前通过
retrieve_context.py召回并通读了 5 篇相似题材原文。 - 成稿经
eval_style.py评估,得分 ≥ 70 分且无高危 AI 套话。
九、仓库目录结构规范
StyleDNA/
├── SKILL.md                    # 主技能定义与执行指南
├── README.md                   # 中文主文档 (技术规范与全量操作手册)
├── README.en.md                # 英文主文档
├── LICENSE                     # MIT 开源协议
├── scripts/                    # 自动化 Python 脚本工具链
│   ├── analyze_corpus.py       # L1 表层语言统计工具
│   ├── analyze_visual.py       # L6 视觉与排版分析工具
│   ├── retrieve_context.py     # 相似语料智能召回器 (BM25)
│   ├── eval_style.py           # 风格吻合度量化评估器
│   └── requirements.txt        # 可选依赖清单
├── agents/
│   └── openai.yaml             # Agent 配置清单
├── references/                 # 参考指南与深度工作流
│   ├── workflow.en.md          # 英文工作流规范
│   ├── batch_distillation.md   # 海量语料分批蒸馏指南 (Map-Reduce)
│   └── prompt_assembly.md      # 写作前上下文动态组装指南
├── docs/                       # 辅助规范文档
│   ├── release-checklist.md    # 发布前检查清单
│   └── usage-boundaries.md     # 使用边界与免责声明
├── templates/
│   └── author-corpus/
│       ├── zh/                 # 中文产物模板与规范
│       └── en/                 # 英文产物模板与规范
├── skills/
│   └── lieflat-less-ai-tone/   # 内置去 AI 味白名单规则集
└── examples/
    └── format-only/            # 格式演示示例目录
十、使用边界与免责声明
- 本项目用于学术研究、写作风格分析与个人写作资产沉淀。
- 严禁利用本项目生成的内容冒充特定作者本人、发布虚假信息或误导公众。
- 开源仓库内不应包含未经原作者授权的私密语料或付费文章原文。
- 复刻的是“写作技法与论证节奏”,严禁直接搬运或抄袭原文中的事实观点与独家数据。
十一、维护与开源许可
- 维护与重构:由 OrcGo 进行架构重构、自动化工具链开发与工程化维护。
- 开源许可:本项目基于 MIT License 开源。
- 作者:赵聪(ZhaoCong),产品经理与独立开发者。